Rano praca. Montaż filmu, renderowanie rozbudowanej sceny 3D albo uruchamianie lokalnego agenta AI i zaprzęgnięcie go do wsparcia lub odwalenia znaczącej części roboty. Wieczorem relaks. Cyberpunk 2077 z ray tracingiem. Laptopy NVIDIA RTX Spark mają płynnie przechodzić między tymi światami, a przy tym nie wyglądać jak ciężkie mobilne stacje robocze. Hasło „work hard, play smart” ma tu jednak w mojej ocenie drugie dno. Sprzęt bierze na siebie ciężkie obliczenia, a użytkownik uczy się mądrze przekazywać AI powtarzalne etapy pracy, odzyskując czas na decyzje, których nie warto oddawać maszynie. Skąd taka interpretacja? Uważam, że to sprzęt przede wszystkim do pracy przy wykorzystaniu sztucznej inteligencji, choć grać na tych laptopach również można – i to w gry AAA! Czy wysoka cena RTX Spark może być inwestycją nie tylko w komputer, ale również w umiejętności, które za kilka lat będą coraz cenniejsze na rynku pracy? Krótko: tak. I to jeden z mocniejszych argumentów za zakupem tego sprzętu.
Laptop z RTX Spark N1X nie jest kolejną mobilną stacją roboczą
Gdy dotąd myśleliśmy o wydajnym laptopie z układem NVIDIA, pod obudową znajdowaliśmy procesor Intela lub AMD, osobną kartę graficzną GeForce i dwa odrębne rodzaje pamięci: systemowy RAM oraz VRAM dostępny dla GPU. NVIDIA RTX Spark zmienia ten układ. Jego sercem jest kompletny SoC, czyli układ łączący procesor NVIDIA Grace oparty na architekturze Arm, zintegrowane GPU Blackwell RTX, NPU oraz pozostałe elementy platformy.
CPU i GPU połączono szybkim interfejsem NVLink-C2C o dwukierunkowej przepustowości sięgającej 600 GB/s. Do dyspozycji jest także 256-bitowa pamięć LPDDR5X o szybkości do 9400 MT/s i przepustowości do 300 GB/s. Najważniejsze nie są tu jednak same liczby, lecz sposób, w jaki wszystkie te elementy ze sobą współpracują.
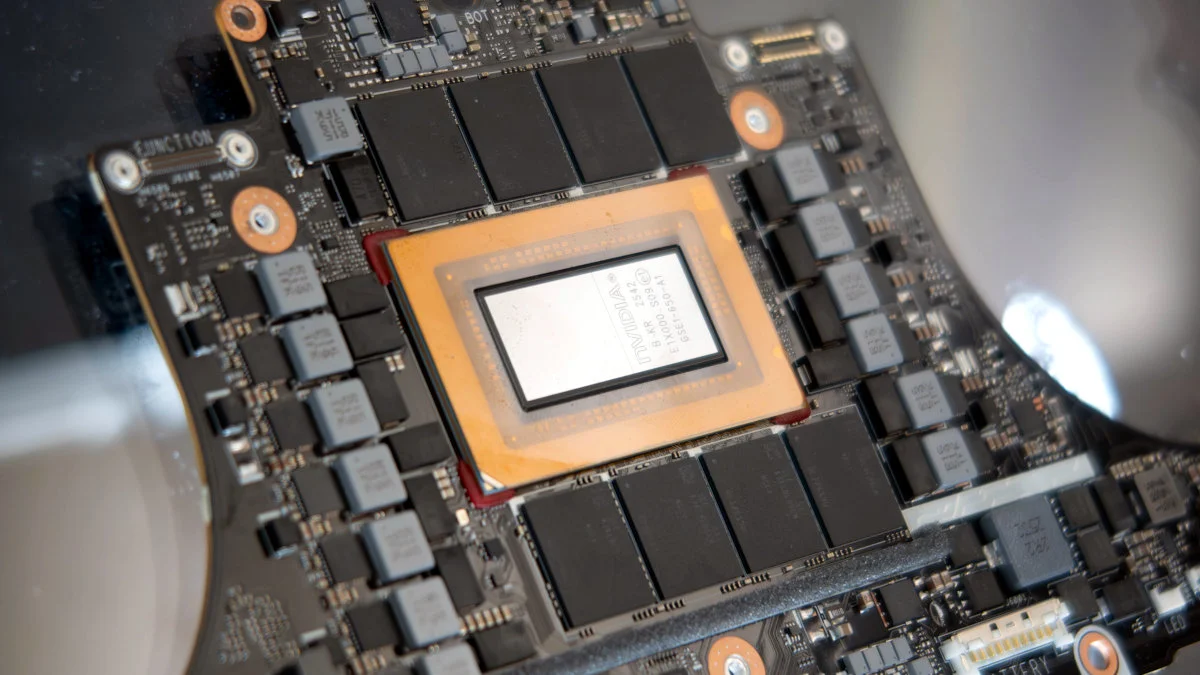
Układ RTX Spark N1X występuje w laptopach w dwóch wersjach. Podstawowy wariant łączy stworzony we współpracy z MediaTekiem 18-rdzeniowy procesor NVIDIA Grace, złożony z dziewięciu rdzeni Cortex-X925 i dziewięciu Cortex-A725, z GPU Blackwell RTX wyposażonym w 5120 rdzeni CUDA. Oferuje wydajność AI sięgającą 827 TFLOPS w obliczeniach FP4 i może współpracować z maksymalnie 32 GB zunifikowanej pamięci LPDDR5X. Mocniejsza odmiana otrzymała 20-rdzeniowy procesor Grace, w którym znalazło się po dziesięć rdzeni Cortex-X925 i Cortex-A725, oraz GPU zawierające 6144 rdzenie CUDA. Jej wydajność AI dochodzi do 1 PFLOP FP4. Co to oznacza w języku zwykłych śmiertelników? Możliwość wykonywania nawet biliarda prostych operacji matematycznych na sekundę przy czterobitowej precyzji wykorzystywanej przez modele AI. Uwaga: nie należy porównywać tej wartości bezpośrednio z wydajnością kart graficznych w grach.
Najbogatsze konfiguracje laptopów mogą korzystać aż ze 128 GB wspólnej pamięci LPDDR5X – te sparowane z wydajniejszą wersją SoC.
W obu przypadkach dostajemy rdzenie RT czwartej generacji, rdzenie Tensor piątej generacji, sprzętowy enkoder i dekoder wideo oraz obsługę technologii dobrze znanych z kart GeForce. W zaprezentowanych dotąd laptopach konfigurowalne TDP SoC mieści się w przedziale od 65 do 80 W, dlatego dwa notebooki z tym samym N1X nie muszą osiągać identycznej wydajności. Znaczenie mają limit mocy, konstrukcja chłodzenia i profil ustawiony przez producenta. Warto je sprawdzić przed zakupem!
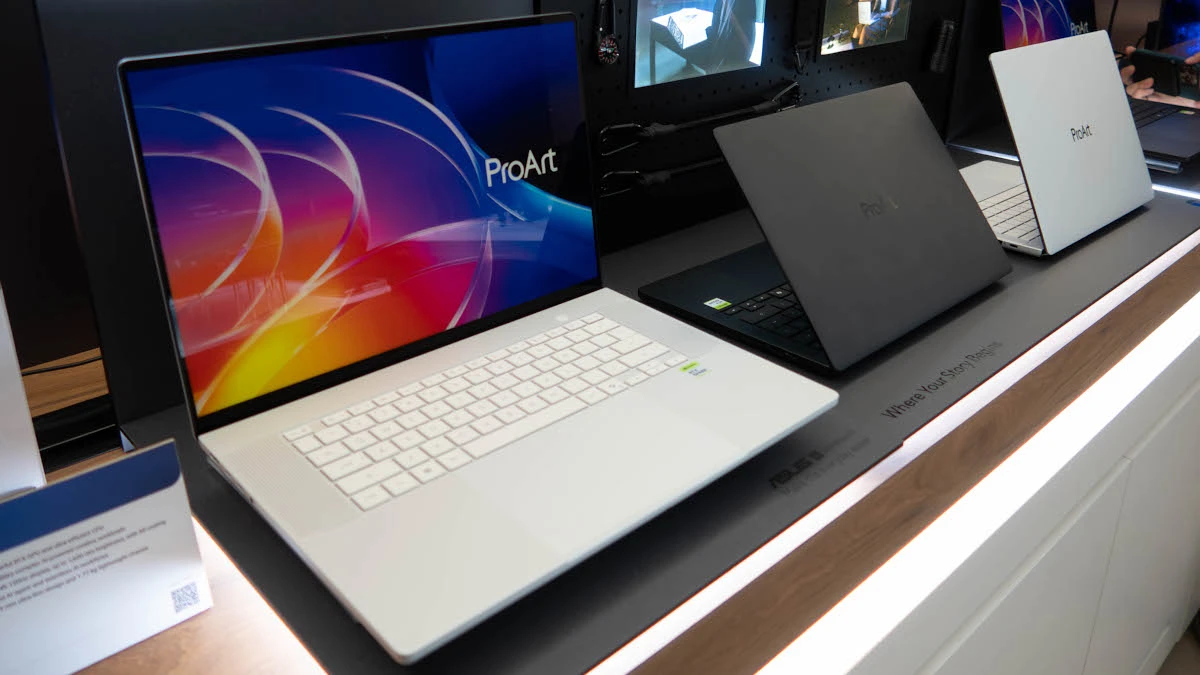
W testowanym przeze mnie laptopie ASUS ProArt P16 pracuje mocniejszy N1X z 20-rdzeniowym CPU, GPU z 6144 rdzeniami CUDA i limitem mocy 80 W. To właśnie ten komputer opisywałem już w pierwszych wrażeniach z ASUS-a ProArt P16. Mój egzemplarz dostał 64 GB pamięci, ale na rynku dostępne są również konfiguracje z 24, 32, 48 oraz 128 GB. I właśnie ostatnia z tych wartości najlepiej pokazuje, dlaczego RTX Spark nie jest po prostu jeszcze jednym procesorem do laptopów.
128 GB pamięci, z której naprawdę może korzystać GPU
W klasycznym wydajnym notebooku procesor korzysta z RAM-u, a karta graficzna ma własny VRAM. Jeżeli aplikacja potrzebuje więcej pamięci graficznej, niż fizycznie umieszczono przy GPU, wydajność gwałtownie spada albo zadania nie da się uruchomić. Mobilny GeForce z 8, 12 czy nawet 16 GB VRAM-u może być bardzo szybki, ale nie zmieści modelu AI, zbioru danych lub sceny 3D zajmującej kilkadziesiąt gigabajtów.
W RTX Spark CPU i GPU korzystają z jednej fizycznej, spójnej puli pamięci. Windows nadal rezerwuje jej część dla systemu, a w aplikacji NVIDIA można określić, ile ma być dostępne po stronie GPU, ale nie jest to tradycyjny, sztywny podział na RAM i VRAM. Odpada też konieczność ciągłego kopiowania dużych porcji danych pomiędzy dwiema osobnymi pulami.
W moim 64-gigabajtowym ProArt P16 dla GPU domyślnie zarezerwowano 32 GB. W modelu ze 128 GB można przydzielić mu znacznie więcej, pozostawiając jednocześnie wystarczający zapas dla Windows i używanych programów. Dzięki temu na smukłym laptopie mieszczą się modele językowe, procesy generowania obrazów i filmów oraz sceny 3D, które normalnie wymagałyby profesjonalnej karty z ogromną ilością VRAM-u albo pracy w chmurze. NVIDIA mówi między innymi o obsłudze modeli do 120 miliardów parametrów, kontekście liczącym nawet milion tokenów i scenach 3D większych niż 90 GB. Ostateczne możliwości zależą oczywiście od formatu modelu, stopnia kwantyzacji, oprogramowania i ilości pamięci pozostawionej systemowi.

To zasadnicza część rewolucji. RTX Spark nie zawsze musi kończyć zadanie szybciej od laptopa z osobnym układem GeForce. Czasem jego przewaga polega na tym, że konkurencyjny komputer w ogóle nie jest w stanie takiego zadania rozpocząć bez przeniesienia części pracy do RAM-u, chmury lub na mocniejszą stację roboczą.
Jeden komputer do wszystkiego? To wymaga doprecyzowania
NVIDIA przedstawia RTX Spark jako platformę do tworzenia, programowania, lokalnej AI i grania. Po pierwszych testach uważam, że to uczciwy opis możliwości, ale nie oznacza on, że urządzenie jest bezwarunkowo najlepsze w każdej z tych dziedzin.
Gwiazdą platformy pozostaje GPU Blackwell RTX. Zadania dobrze wykorzystujące CUDA, rdzenie Tensor, ray tracing, sprzętowe kodowanie wideo i przetwarzanie równoległe wypadają bardzo dobrze. Procesor Grace również nie jest wyłącznie dodatkiem do mocnej grafiki. Dzięki 18 lub 20 rdzeniom radzi sobie zwłaszcza z obciążeniami wielowątkowymi, kompilacją, transkodowaniem i intensywną wielozadaniowością. Wydajność jednego rdzenia nie należy natomiast do ścisłej czołówki obecnych układów mobilnych. W codziennej pracy trudno uznać komputer za powolny, ale starsze aplikacje zależne głównie od jednego wątku nie pokazują pełni możliwości N1X.
Taki rozkład sił ma sens, bo RTX Spark powstał z myślą o świecie, w którym coraz większą część pracy wykonują akceleratory. Montaż, renderowanie, generowanie obrazu, transkrypcja, lokalne modele językowe czy agenty programistyczne coraz częściej opierają się na GPU. To właśnie w tych zastosowaniach nowa platforma czuje się najlepiej.
Wnioski z opublikowanych dotąd niezależnych testów są zresztą bardzo podobne. Wyniki RTX Spark w klasycznych aplikacjach, eksporcie wideo i grach zależą od programu oraz limitu mocy laptopa, ale recenzenci niemal jednogłośnie wskazują lokalną AI jako szczególnie mocną stronę platformy. Najlepiej wypadają zadania wykorzystujące CUDA i rdzenie Tensor, zwłaszcza modele kwantyzowane, generowanie obrazu oraz wieloetapowa praca agentów. Innymi słowy: nie jest to procesor wygrywający każdy test, lecz bardzo sprawny silnik dla obciążeń, które będą miały coraz większe znaczenie.
Work hard, play smart: najpierw trzeba nauczyć się delegować
Największa korzyść z AI pojawia się wtedy, gdy potrafimy rozłożyć własną pracę na etapy i zdecydować, które z nich wymagają naszej wiedzy, a które może przejąć model lub agent. Człowiek nadal określa cel, ocenia wynik i bierze za niego odpowiedzialność. Maszyna przeszukuje materiały, porównuje dane, tworzy warianty, wykonuje obliczenia i pilnuje powtarzalnych czynności. Właśnie to rozumiem przez inteligentne korzystanie z AI. Chodzi o umiejętność przekazania modelowi odpowiedniego kontekstu, dobrania narzędzi, ustawienia zakresu uprawnień i zbudowania punktów kontroli. Trzeba również wiedzieć, kiedy wystarczy model lokalny, kiedy warto sięgnąć do chmury i w jaki sposób zweryfikować rezultat. Raz dopracowany proces można później zapisać jako procedurę lub umiejętność agenta i wykorzystywać przy kolejnych projektach.
Osoby, które zaczną ćwiczyć to już teraz, zyskują coś więcej niż kilka zaoszczędzonych godzin. Budują praktyczną wiedzę o współpracy z agentami, podczas gdy inni dopiero zastanawiają się, do czego może przydać się chatbot. Konkretne modele i aplikacje zapewne wielokrotnie się zmienią, ale zdolność projektowania procesu, kontrolowania jakości i łączenia AI z wiedzą branżową pozostanie wartościowa. To może zdecydować, kto za kilka lat będzie jedynie korzystał z gotowych rozwiązań, a kto będzie wyznaczał sposób ich użycia w swojej firmie lub zawodzie.
RTX Spark nie daje tej przewagi automatycznie. Daje natomiast bardzo dobre warunki, aby ją budować: dużą pamięć dla modeli, pełny ekosystem CUDA, możliwość lokalnego wykonywania wielu prób bez opłaty za każdy token oraz swobodę łączenia agentów z profesjonalnymi aplikacjami. Laptop staje się wówczas nie tylko narzędziem do wykonania dzisiejszego zlecenia, ale również osobistym laboratorium do nauki sposobu pracy, który może za chwilę stać się standardem.
No dobra, ale o co w ogóle chodzi z tymi agentami?
Lokalny agent AI jest czymś więcej niż chatbotem
Najważniejszym argumentem za laptopem z RTX Spark nie jest możliwość zadawania modelowi kolejnych pytań. Odpowiedzi na nie udzielą darmowi asystenci dostępni z poziomu przeglądarki. Różnica zaczyna się wtedy, gdy AI ma pracować na lokalnych plikach, korzystać z zainstalowanych programów i wykonywać wieloetapowe zadania. Dobrym przykładem jest Hermes Agent od Nous Research.
Na laptopach z RTX Spark jego instalacja w Windows 11 na Arm nie wymaga przekopywania się przez repozytoria, ręcznego dobierania zależności i kilku godzin spędzonych w terminalu. System prowadzi użytkownika do instalatora, a aplikacja może dobrać lokalny model oraz ustawienia do ilości dostępnej pamięci. W praktyce instalacja sprowadza się do kilku kliknięć i poradzi sobie z nią nawet amator.
Hermes nie ogranicza się do generowania odpowiedzi. Może czytać i porządkować pliki, pisać skrypty, uruchamiać narzędzia, przeszukiwać dokumenty, przygotowywać grafiki, wykonywać zaplanowane czynności oraz zapamiętywać skuteczne sposoby realizacji powtarzalnych zadań. Jeżeli przyznamy mu odpowiednie uprawnienia, może także pracować pomiędzy aplikacjami. Dziennikarz wykorzysta go do transkrypcji rozmowy, przeszukania archiwum, odnalezienia cytatów i porównania wersji tekstu. Fotograf zleci opisanie oraz posegregowanie materiału, a montażysta przygotowanie napisów, tłumaczeń, listy ujęć albo pierwszej wersji storyboardu. Programista może pozwolić agentowi przeanalizować repozytorium, napisać fragment kodu, uruchomić testy i poprawić wykryte błędy. Chcesz, aby napisał dla Ciebie stronę internetową? Zrobi to i to całkiem szybko.
Duża część tej pracy może odbywać się bez wysyłania materiałów na zewnętrzny serwer. Ma to znaczenie przy kodzie objętym tajemnicą firmy, nieopublikowanych nagraniach klienta, umowach, dokumentacji technicznej czy bazie firmowej wiedzy. Po pobraniu modelu nie ma też opłaty za każde kolejne zapytanie ani oczekiwania w kolejce usługi chmurowej. Nie znaczy to, że lokalna AI zawsze odpowie szybciej lub mądrzej od największego modelu dostępnego online. Daje jednak kontrolę, prywatność, pracę bez internetu i możliwość wielokrotnego przetwarzania danych bez nabijania rachunku za tokeny.
Agenci mogą również działać hybrydowo. Prostsze lub poufne zadanie zostaje wykonane lokalnie, a trudniejsze – za zgodą użytkownika – trafia do modelu w chmurze. NVIDIA OpenShell i mechanizmy bezpieczeństwa Microsoftu mają przy tym zamykać agentów w kontrolowanym środowisku, chronić dane uwierzytelniające i pozwalać dokładnie określić, do jakich plików, aplikacji oraz połączeń sieciowych dostaną dostęp. To ważne, bo im więcej może agent, tym rozsądniej należy przydzielać mu uprawnienia.
Mój workflow: AI pomaga w researchu, ale nie pisze za mnie
Przygotowując swoje publikację traktuję AI jako asystenta researchu. Najpierw zbieram własne notatki, wyniki pomiarów i przemyślenia. Później konfrontuję je z przedpremierowymi zapowiedziami producenta, a czasami weryfikuję to wszystko jeszcze z recenzjami z całego świata. Czasami generuję sobie za darmo, lokalnie, grafiki do artykułów, aby nie zużywać tokenów w płatnych programach. Wreszcie, sztuczna inteligencja robi korektę tekstu – znacznie skuteczniej niż programy biurowe. Nierzadko pomaga wygładzić niektóre zdania, czy też sugeruje nadanie szerszego kontekstu.
Chodzi o optymalizację pracy.
Ten sam newsroomowy proces można przenieść na lokalnego Hermesa w laptopie z RTX Spark. Agent otrzymuje dostęp wyłącznie do katalogu projektu, odczytuje informacje prasowe, transkrypcje, notatki i arkusze z benchmarkami, a następnie uruchamia skrypt liczący średnie, tworzy tabelę porównawczą oraz checklistę brakujących danych. Poufne materiały objęte embargiem nie muszą opuszczać komputera. Po zakończeniu pracy nad artykułem ten sam zestaw informacji może posłużyć do przygotowania listy ujęć do filmu, opisu na YouTube albo skróconego scenariusza na TikToka.
Na tym polega moje „play smart”. AI nie zastępuje doświadczenia, nie wybiera za mnie tezy artykułui nie podpisuje się pod publikacją. Usuwa za to sporą część mechanicznego researchu, pilnuje kompletności materiału i pozwala szybciej przejść do pracy wymagającej oceny oraz autorskiego spojrzenia. Co równie ważne: raz przygotowany workflow można udoskonalać przy każdym kolejnym teście zamiast za każdym razem zaczynać od pustej kartki.
Od szkicu domu do modelu i renderów w 26 minut
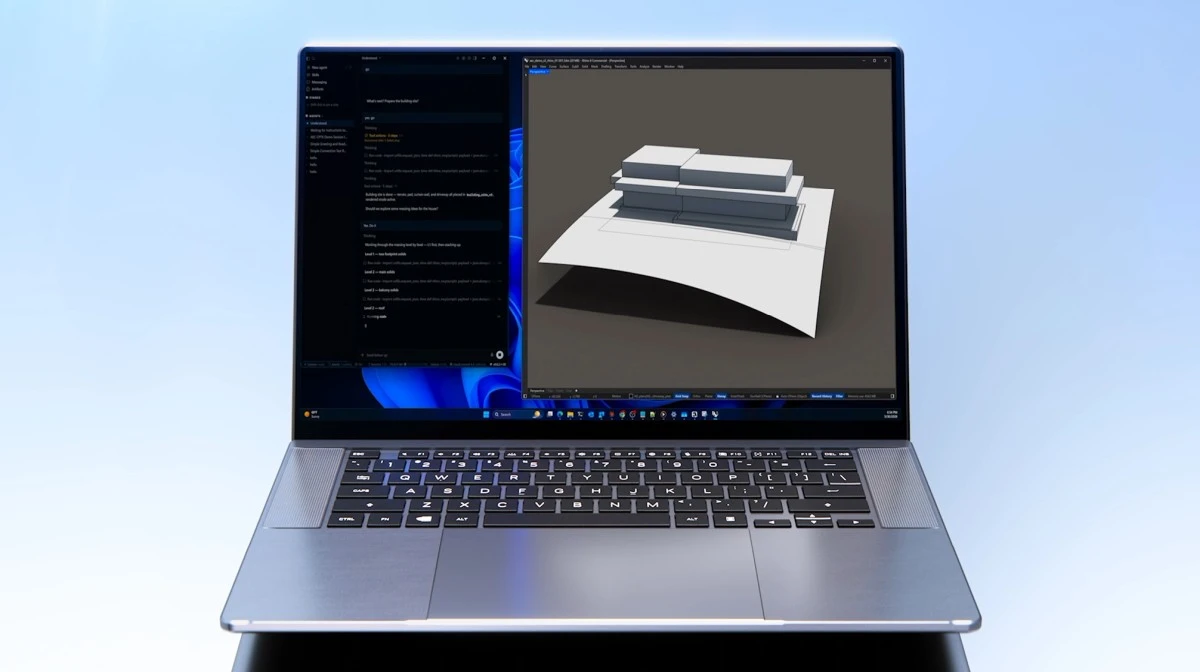
Najbardziej obrazowy pokaz możliwości RTX Spark, jaki oglądałem podczas prezentacji NVIDIA w San Francisco, dotyczył pracy architekta. Przyznam, że podziałał tak na moją wyobraźnię, jak i mojego przyjaciela, architekta. Punktem wyjścia były działka, szkice koncepcyjne, moodboard i tekstowy opis wymagań. Agent działający w środowisku Hermes na laptopie otworzył Rhino, wymodelował teren, uwzględnił wymagane odsunięcia oraz dopuszczalną obwiednię budynku, a następnie zaproponował bryły zoptymalizowane pod kątem kosztu, komfortu i jakości.
Po zatwierdzeniu kierunku wygenerował układ wnętrza: komunikację, ściany i pomieszczenia. Automatycznie dodał drzwi, okna oraz elementy konstrukcyjne, a zauważone przez siebie błędy próbował poprawiać. Użytkownik nadal mógł na każdym etapie zatrzymać proces, zmienić założenia i zaakceptować kolejną wersję. Później agent przeniósł projekt z Rhino do Blendera wraz z materiałami, właściwościami obiektów i kontekstem projektu. Po ręcznym dopracowaniu materiałów i wybraniu kadrów Blender przygotował obrazy, a model FLUX.2 nadał im fotorealistyczny wygląd w kilku wariantach oświetlenia. Cały pokaz przejścia od założeń do kompletnego modelu koncepcyjnego i wizualizacji zamknął się w około 26 minut.
Ten przykład dobrze pokazuje, po co platformie jednocześnie mocny CPU, GPU z CUDA, dużo wspólnej pamięci i środowisko dla agentów. Nie chodzi o pojedyncze polecenie wygenerowania ładnego obrazka. Agent prowadził pracę przez kilka specjalistycznych programów, zachowując dane pomiędzy etapami i zostawiając człowiekowi decyzje projektowe. Te same czynności można by oczywiście wykonać na pececie z klasycznym GPU, ale zbyt mała ilość pamięci na GPU sprawiłaby, że proces ten wymagałby już podzielenia na kolejne etapy. Tutaj, wszystko to może działać automatycznie, po kolei i jednocześnie, kiedy Wy, gdzieś w tle, macie uruchomiony jeszcze program do edycji wideo lub Blendera z niemałym projektem.
Demonstracja nie była formalnym projektem wykonawczym ani zatwierdzonym obliczeniem nośności konstrukcji. Agent rozmieszczał elementy konstrukcyjne i uwzględniał założenia działki, ale dokumentację, obliczenia wytrzymałościowe oraz zgodność z przepisami nadal musi zweryfikować uprawniony specjalista. Taki proces można rozszerzyć o bazy norm, katalogi materiałów i programy obliczeniowe, lecz AI pozostaje narzędziem przyspieszającym kolejne iteracje, a nie stroną biorącą odpowiedzialność za bezpieczeństwo budynku.
Jest jeszcze jeden istotny szczegół. W pokazie środowisko agenta i programy działały na RTX Spark, natomiast Hermes korzystał także z modelu Claude Sonnet w chmurze. Był to więc przykład inteligencji hybrydowej, a nie procesu całkowicie offline. Nie odbiera mu to jednak wartości. Przeciwnie, dobrze pokazuje praktyczny scenariusz: lokalny komputer przechowuje projekt, obsługuje aplikacje, renderuje i może uruchamiać własne modele, a chmura włącza się tylko tam, gdzie potrzebne jest mocniejsze rozumowanie.
Wszystko zależy od użytkownika.
Twórca dzięki RTX Spark dostaje znacznie więcej niż generator obrazów
AI jest głównym wyróżnikiem RTX Spark, ale platforma ma wykonywać również zwykłą, ciężką pracę kreatywną. GPU Blackwell RTX obsługuje OptiX, ray tracing i technologie DLSS przydatne nie tylko w grach. Blender 5.3 ma w listopadzie otrzymać DLSS Ray Reconstruction do oczyszczania podglądu w silniku renderującym Cycles (już widziałem to rozwiązanie w akcji), a aplikacje Adobe są dostosowywane do nowej architektury. W wersjach beta Premiere Pro akcelerowane przez TensorRT są między innymi maskowanie obiektów, poprawa dźwięku, wykrywanie zmian scen i automatyczne kadrowanie. Photoshop może lokalnie usuwać obiekty z wykorzystaniem AI.
Sprzętowy enkoder i dekoder obsługują H.264, HEVC oraz AV1, w tym materiał 4:2:2. Ma to pozwalać na płynną pracę z wysokiej jakości plikami prosto z aparatu, bez tworzenia zastępczych materiałów o obniżonej rozdzielczości. NVIDIA wskazuje nawet na montaż materiału 12K 4:2:2 i generowanie wideo 4K przy pomocy AI, choć w praktyce płynność zawsze będzie zależała od kodeka, liczby ścieżek, efektów oraz optymalizacji konkretnego programu.
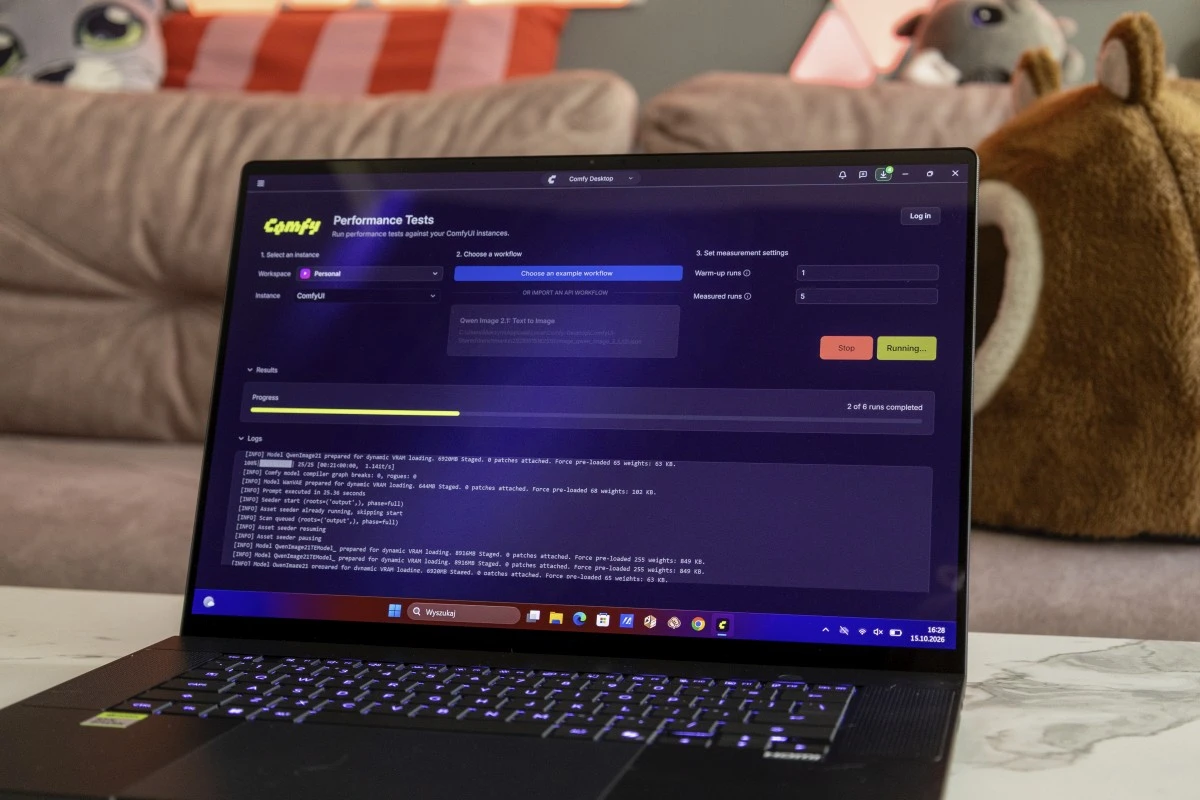
W pierwszych testach na ASUS-ie ProArt P16 generowanie pojedynczego obrazu w ComfyUI z użyciem Qwen Image 2.1 zajmowało około 21 sekund. Mój komputer stacjonarny z Core i9-13900K i GeForce RTX 5080 potrzebował około 9,5 sekundy. RTX Spark nie pobił więc mocnego peceta, ale porównujemy smukły laptop zużywający wielokrotnie mniej energii z pełnowymiarowym desktopem. Ważniejsze jest to, że konfiguracje z 64 lub 128 GB pamięci pozwalają uruchamiać większe modele i bardziej rozbudowane grafy ComfyUI niż większość mobilnych kart graficznych.
ASUS ProArt P16 pokazuje też, jak taka platforma może wyglądać w praktyce. Laptop waży 1,77 kg, ma akumulator 99,9 Wh i 16-calowy ekran OLED 120 Hz. W zależności od wersji jest to panel 3K lub 4K o pełnym pokryciu DCI-P3, przeznaczony zarówno do pracy z kolorem, jak i oglądania gotowego materiału. Do tego dochodzą bardzo dobre głośniki, duży gładzik haptyczny, czytnik kart SD i porty potrzebne twórcom. To sprzęt, który można zabrać na plan, do klienta lub w podróż bez noszenia typowej, grubej stacji roboczej.
Czas pracy na baterii? Jest mocno uzależniony od tego, co robimy na laptopie. Mam wrażenie, że NVIDIA ma tu jeszcze spore pole do dalszych optymalizacji, bo czasami jest nieźle, a czasami… mogłoby być lepiej – w końcu mamy tu do czynienia z ARM.
Programista może zabrać ze sobą małe laboratorium AI
RTX Spark ma sens również dla osób tworzących oprogramowanie. CUDA działa na platformie natywnie, a NVIDIA i Microsoft przygotowały dla Windows na Arm między innymi PyTorch z obsługą CUDA, natywnego Pythona, instalator Conda oraz wsparcie dla zdecydowanej większości najpopularniejszych pakietów. Można pracować bezpośrednio w Windows albo skorzystać z WSL 2 z dostępem do GPU i środowiska zbliżonego do tego, do którego projekt trafi później w chmurze lub centrum danych.
Duża pamięć pozwala lokalnie uruchamiać modele do pisania kodu, testować aplikacje AI, wykonywać inferencję i eksperymentować z dostrajaniem bez każdorazowego wynajmowania instancji GPU. Agent może czytać kod, edytować pliki, uruchamiać testy i przechowywać w kontekście więcej dokumentacji oraz historii projektu. Ten sam ekosystem CUDA ułatwia później przeniesienie pracy z laptopa na stację roboczą, serwer lub usługę chmurową z układami NVIDIA.
Dla programisty wartością nie jest zatem wyłącznie szybsza kompilacja. To również środowisko, w którym można uczyć agenta specyfiki projektu, budować własne narzędzia i sprawdzać je na lokalnym modelu bez wysyłania całego repozytorium poza komputer. RTX Spark obniża próg wejścia od strony obsługi, a jednocześnie daje zapas pamięci pozwalający wyjść daleko poza proste modele działające na zwykłym laptopie.
Po pracy można naprawdę pograć
RTX Spark nie jest pozycjonowany jako układ wyłącznie gamingowy, ale wewnątrz nadal znajduje się pełnoprawne GPU RTX Blackwell. Dostajemy zatem obsługę ray i path tracingu, techniki NVIDIA Reflex, G-SYNC i kompletny zestaw funkcji DLSS 5, w tym Super Resolution, Ray Reconstruction oraz Dynamic Multi Frame Generation. Dzięki nim smukły komputer do pracy może po godzinach uruchomić współczesne gry AAA w sensownej jakości. Często z włączonym generatorem klatek, ale takie już mamy czasy.
Na ASUS-ie ProArt P16 Counter-Strike 2 działał w maksymalnych detalach i natywnej rozdzielczości 2880×1800 pikseli ze średnią wynoszącą około 70 klatek na sekundę. W Cyberpunku 2077, po ustawieniu wysokich detali, włączeniu ray tracingu, DLSS w trybie jakości i generowania klatek 3x, zobaczyłem około 55 klatek na sekundę. Bez ray tracingu i bez generowania klatek wynik przekraczał 45 klatek. Uruchomiłem również Fortnite, Forzę Horizon 5 i Red Dead Redemption 2 po przełączeniu API z DirectX 12 na Vulkan. Lwia część gier nie działa natywnie, a i tak działa co najmniej dobrze.
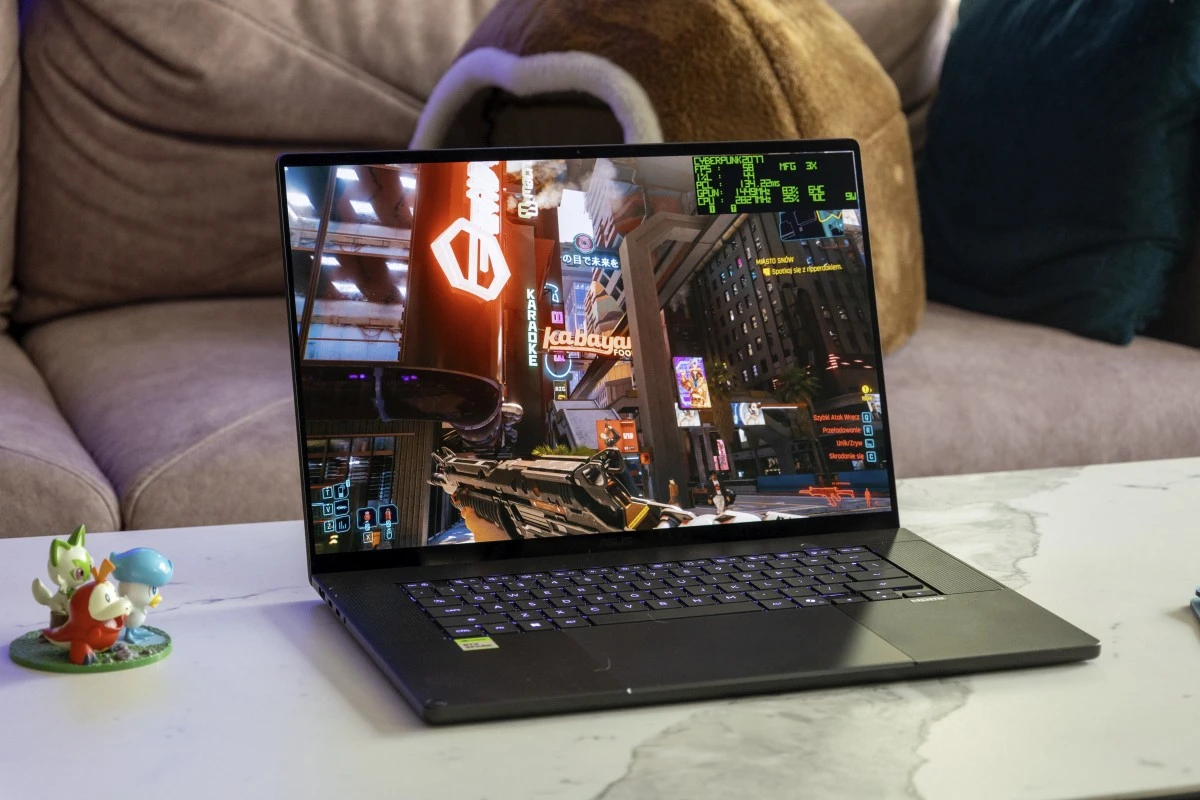
Wydajność w grach zależy od ustawień, limitu mocy konkretnego laptopa i jakości emulacji kodu x86 przez warstwę Prism. W moich pomiarach platforma plasowała się najczęściej nieco poniżej laptopowego GeForce’a RTX 5060, a wynik około 3000 punktów w 3DMark Steel Nomad pokazuje, że nie jest to zamiennik najmocniejszych konstrukcji gamingowych. Zdarzają się też produkcje blokowane przez niezgodny z Windows na Arm system anti-cheat, choć lista obsługiwanych zabezpieczeń stale rośnie.
Nie kupowałbym więc RTX Spark wyłącznie po to, aby uzyskać możliwie najwięcej klatek za każdą wydaną złotówkę. Jako dodatkowa funkcja profesjonalnego laptopa gaming wypada jednak przekonująco. Po skończonym renderze, montażu albo – czy raczej: przede wszystkim – pracy z agentem AI nie trzeba przesiadać się na drugi komputer. Wystarczy uruchomić grę i rozsądnie dobrać ustawienia graficzne oraz te związane z technologią DLSS.
Windows na Arm jest już dojrzały, lecz warto sprawdzić swój warsztat
Nowoczesne aplikacje działające natywnie na Arm potrafią bardzo dobrze wykorzystać RTX Spark, a emulator Prism radzi sobie z ogromną częścią oprogramowania x86 i x64 bez angażowania użytkownika. Microsoft regularnie aktualizuje warstwę zgodności i dostosował ją do mikroarchitektury N1X. Nie oznacza to jednak stuprocentowej kompatybilności każdego istniejącego programu i urządzenia.
Przed zakupem tak drogiego laptopa należy sprawdzić nie tylko główną aplikację, lecz także cały używany zestaw: starsze wtyczki, kodeki, sterowniki urządzeń przechwytujących, interfejsy audio, kalibratory ekranu, narzędzia VPN i zabezpieczenia gier. Wiele programów ruszy przez emulację, ale specjalistyczny sterownik przygotowany wyłącznie dla x64 może stać się problemem. Jest to coraz krótsza lista wyjątków, jednak dla profesjonalisty jedna brakująca wtyczka bywa ważniejsza niż dziesięć świetnych benchmarków.
Skąd ta cena i kto może ją uzasadnić?
ASUS ProArt P16 z RTX Spark kosztuje obecnie w Polsce od 14 999 zł za wersję ze słabszym N1X i 32 GB pamięci. Testowana przeze mnie konfiguracja z 20-rdzeniowym CPU, GPU z 6144 rdzeniami CUDA i 64 GB pamięci została wyceniona na 19 999 zł, a model ze 128 GB pamięci oraz dyskiem 2 TB na 27 999 zł. To kwoty, przy których nie wystarczy powiedzieć, że komputer jest szybki. Nie oszukujmy się: konkurencja istnieje.
Na cenę składa się bardzo duża ilość szybkiej pamięci LPDDR5X, rozbudowany SoC produkowany w litografii 3 nm, wydajne chłodzenie, akumulator o niemal maksymalnej pojemności dopuszczanej w samolotach, wysokiej klasy OLED i smukła, lekka obudowa. Płaci się jednak przede wszystkim za połączenie cech, których trudno szukać razem gdzie indziej: pełny ekosystem CUDA i RTX, nawet 128 GB pamięci dostępnej dla GPU, obsługa lokalnych modeli AI oraz agentów, profesjonalne aplikacje Windows i możliwość grania w tytuły AAA.
Jeśli komputer służy głównie do przeglądarki, pakietu biurowego i gier, zakup RTX Spark trudno obronić. Tańszy laptop x86 z osobnym układem GeForce zapewni lepszy stosunek liczby klatek do ceny. Inaczej wygląda rachunek osoby, która codziennie generuje materiały, analizuje poufne dokumenty, tworzy modele AI, pracuje na dużych scenach 3D albo płaci za chmurowe GPU i miliony tokenów. Wtedy lokalne przetwarzanie może ograniczyć stałe koszty, skrócić czas oczekiwania i zastąpić kilka narzędzi jednym mobilnym urządzeniem. Teoretyczną i przecież niemobilną alternatywą dla tego komputera do takich zastosowań są tak naprawdę wyłącznie stacje robocze z kartami graficznymi NVIDIA RTX Pro 6000, których ceny – podkreślam: samych kart, nie całych stacji – dobijają teraz do… 100 tysięcy złotych.
Sam zakup drogiego komputera nie uczyni jednak nikogo specjalistą od AI. Jeżeli RTX Spark będzie służył wyłącznie do zadawania prostych pytań chatbotowi, duża część jego potencjału pozostanie niewykorzystana. To potężne narzędzie do nauki i efektywnego wykorzystania sztucznej inteligencji. Work hard, play smart – pamiętacie jeszcze co pisałem we wstępie do tego artykułu? Cena zaczyna mieć więcej sensu wtedy, gdy laptop staje się warsztatem do budowania, testowania i poprawiania własnych procesów. Płacimy nie tylko za możliwość wykonania dzisiejszego zadania, ale też za swobodę zdobywania kompetencji, które mogą usprawniać kolejne projekty przez kilka następnych lat.
Najlepszym uzasadnieniem ceny nie jest zatem żaden syntetyczny wynik w benchmarku, lecz realnie odzyskany czas. Jeżeli agent odciąży twórcę, katalogując materiały, przygotuje pierwszą wersję projektu, uruchomi testy kodu w tle albo pozwoli wykonać u klienta pracę, która wcześniej wymagała powrotu do stacji roboczej, sprzęt może zacząć na siebie zarabiać. Im częściej wykorzystujemy lokalną AI, tym łatwiej wykorzystać to, za co dopłaciliśmy.
Dla kogo są laptopy NVIDIA RTX Spark?
NVIDIA RTX Spark to wyspecjalizowana platforma, która ma wyjątkowo szeroki zakres możliwości: od lokalnych agentów i dużych modeli AI, przez montaż, renderowanie oraz programowanie, aż po granie po godzinach. Jej prawdziwą przewagą jest sytuacja, w której typowy laptop zatrzymuje się na limicie pamięci albo wymaga wysłania projektu do chmury. Ze względu na cenę nie jest to komputer dla każdego, ale każdy, kto przez chwilę z nim poobcuje, z miejsca dostrzeże, że to urządzenie niezwykłe, przełomowe i na swój sposób inne niż wszystkie.
Największy potencjał zobaczą dziś twórcy, deweloperzy, architekci, analitycy oraz entuzjaści AI, którzy chcą już teraz zaprząc agentów do codziennej pracy, a nie dopiero obserwować, jak robią to inni. RTX Spark nie obiecuje, że AI wykona bezbłędnie wszystko za człowieka. Daje za to odpowiednio mocny, przenośny i otwarty technologicznie warsztat, aby uczyć się współpracy ze sztuczną inteligencją, popełniać błędy na własnych zasadach i stopniowo zamieniać pojedyncze polecenia w złożone procesy. Procesy pozwalające oszczędzać (odzyskiwać?!) czas i pieniądze.
Po zamknięciu narzędzi do pracy nadal dostajemy bardzo dobry laptop multimedialny z ekranem OLED, świetnymi głośnikami i GPU pozwalającym odpalić wymagającą grę. „Work hard, play smart” ma więc w wydaniu RTX Spark podwójne znaczenie. N1X wykonuje ciężką pracę obliczeniową, użytkownik sprytniej organizuje swoją pracę z pomocą AI, a po jej zakończeniu na tym samym komputerze może po prostu uruchomić grę. Nie chodzi tu o bezkonkurencyjność w jednej kategorii, lecz o sprzęt, który pozwala dziś tworzyć i odpoczywać, a jednocześnie przygotowywać się do sposobu pracy jutra. A jak mawiał mój historyk: jutro nadejdzie szybciej, niż myślisz.
Materiał powstał we współpracy z firmą NVIDIA