Nvidia przez lata celowo blokowała konsumenckie karty graficzne z serii GeForce RTX 20, RTX 30 i 40, co miało ochronić sprzedaż drogich układów serwerowych. Teraz znaleziono sposób na zdjęcie tego kagańca. Udało się odblokować ukryty potencjał rdzeni Tensor w kartach bazujących na architekturach Turing, Ampere i Ada Lovelace. Po zastosowaniu eksploitu szczytowa wydajność w operacjach sztucznej inteligencji rośnie nawet dwukrotnie.
Kod z GitHub uwalnia moc starych układów RTX
Żeby korporacje i serwerownie nie kupowały tańszych GeForce’ów zamiast drogich Tesli czy kart z serii RTX A, producent po prostu programowo obcinał prędkość instrukcji macierzowych.
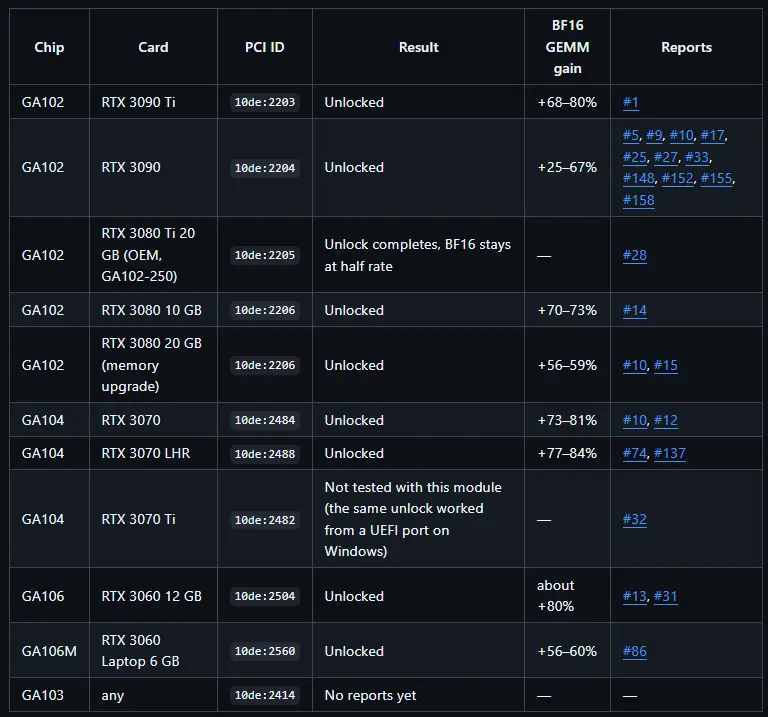
Projekt nosi nazwę gpu-unlock. Metoda opiera się na błędzie typu przepełnienie bufora na stosie w podpisanym oprogramowaniu SEC2 „Booter”. Wystarczy zapisanie krótkiego, 4-bajtowego ładunku V67 w odpowiednim momencie, by odblokować rejestry kontrolne i podmienić identyfikator PCIe Device ID karty na model z linii profesjonalnej.
Całość odbywa się w pamięci RAM na poziomie jądra Linuksa przed startem oficjalnego sterownika. Modyfikacja ma charakter tymczasowy – znika po ponownym uruchomieniu komputera, dzięki czemu nie trzeba modyfikować plików na dysku ani martwić się o aktualizacje sterowników.
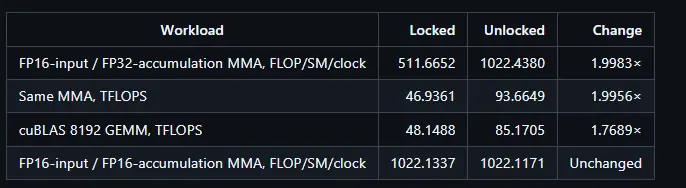
Różnice w syntetycznych testach są ogromne. Topowy GeForce RTX 4090 po zdjęciu blokady wskakuje w operacjach FP16 i BF16 ze 165 TFLOPS na ponad 330 TFLOPS. Podobny, niemal stuprocentowy skok wydajności notuje dawny flagowiec RTX 2080 Ti w precyzji FP16. Z kolei RTX 3090 Ti w operacjach TF32 przyspiesza z 42,5 TFLOPS do ponad 82 TFLOPS.
Niestety, w grach nie ma żadnej różnicy
W praktycznych zastosowaniach realny zysk zależy od konkretnego zadania, architektury oraz ustawionego limitu mocy. Bardzo mocno zyskują lokalne modele językowe w fazie przetwarzania promptu.
W środowisku vLLM czas przygotowania kontekstu (prefill) skraca się od 14% do nawet 36%. Ponadto opóźnienie pierwszego wygenerowanego tokena spada o jedną czwartą. Modyfikacja świetnie sprawdza się również przy generowaniu obrazów oraz w bibliotece FlashAttention. Nic nie zmienia się natomiast w samej szybkości generowania kolejnych słów przez chatboty, gdyż ten proces ogranicza przepustowość pamięci VRAM.
Zabawa nie przyniesie żadnych korzyści osobom szukającym dodatkowych klatek w grach wideo. Renderowanie trójwymiarowe i algorytmy DLSS wykorzystują pełną moc karty i fabrycznie nie podlegają tym ograniczeniom.
Narzędzie przygotowano z myślą o systemie Linux, podczas gdy wersje dla Windowsa pozostają w stadium eksperymentalnym. Najnowsza architektura Blackwell (RTX 50) i profesjonalne układy Hopper nie są obsługiwane. Autorzy modyfikacji ostrzegają, że używanie eksploitu wiąże się z ryzykiem niestabilności systemu, utraty danych, a w skrajnych przypadkach uszkodzenia sprzętu.
Źródło: Tom’s Hardware, GitHub / Zdj. otwierające: Unsplash (@christianw)